El oído que lo capta todo: altas capacidades y el diálogo que no se entiende

Eduardo G. Garba · colaborador de iPopulus
Portal y Red Social de Altas Capacidades • Desde 2008
La hipersensibilidad es una de esas características que aparecen una y otra vez en los perfiles de altas capacidades: luces que molestan, ruidos que duelen, etiquetas que raspan. Pero también hay una cara menos conocida, la del oído que quiere entenderlo todo y se frustra cuando no puede. El cine en casa es un buen laboratorio de ese tipo de frustración.
Del ruido que molesta a la palabra que se pierde
Hablamos mucho de los sonidos que sobrecargan a una persona con altas capacidades: el golpe de la puerta, el fluorescente que zumba, el volumen de una fiesta. Es real. Pero hay otra experiencia igual de incómoda y mucho menos comentada: querer seguir una conversación o una película y quedarte fuera.
Las mezclas de cine están pensadas para una sala calibrada. El diálogo llega bajo, y los efectos irrumpen con un rango dinámico enorme. En un televisor moderno con barra de sonido se puede compensar. En una tele antigua con dos altavoces pequeños, el resultado suele ser una sucesión de "¿qué ha dicho?" y de sustos en plena siesta.
Y cuando el cerebro va sobrado de capacidad de procesamiento, esa tensión se nota más. No es solo que no se oiga; es que el esfuerzo de inferir lo que dicen consume una atención que podría estar disfrutando de la historia. La fatiga llega antes que la trama.
Una solución pensada, no una ocurrencia
Nuestro colaborador estrecho en el portal, el ingeniero y escritor Eduardo G. Garba, lleva tiempo trabajando en esto desde una perspectiva técnica. El resultado es el Algoritmo Zainder, un procesado de audio que está documentado en un paper con DOI: https://doi.org/10.5281/zenodo.24437921.
La idea de fondo es sencilla y muy razonable: no se trata de subir el volumen, sino de darle espacio a la voz. La mezcla se separa en dos carriles, uno para la voz y otro para el fondo. Cada uno se trata con sus propios parámetros y luego se vuelven a unir, con el fondo retirándose cuando alguien habla.
- Separación previa de voz y ambiente.
- Compresión asimétrica: más sujeción en la voz que en el resto.
- Ecualización de inteligibilidad: se recorta un poco donde la voz suena hueca y se refuerza la franja de las consonantes.
- Ducking por cadena lateral, para que el fondo ceda justo cuando alguien habla.
- Normalización y limitador para controlar picos y saltos de nivel.
Todo con un único control de intensidad, de 0 a 1, porque el autor insiste en un punto que nos parece capital: hay quien solo quiere un poco de ayuda, y hay quien necesita el diálogo por encima de todo.
Lo que se sabe y lo que queda por demostrar
Aquí conviene hacer un ejercicio de humildad analítica, algo que en este portal valoramos. El autor documenta con todo lujo de detalles su cadena, incluidas las cuentas de compresión, las frecuencias de ecualización y los niveles de salida. También deja clarísimo lo que aún no está probado: la comprobación se ha hecho con señales sintéticas, y todavía falta validación con películas reales y, sobre todo, con personas escuchando.
Para eso propone un protocolo con métricas objetivas como STOI o el índice de inteligibilidad del habla, medidas de sonoridad conforme a la norma BS.1770 y pruebas subjetivas. Es decir: no vende resultados que no tiene.
Por qué nos parece relevante para altas capacidades
Porque habla de accesibilidad, de bienestar sensorial y de respeto a la atención ajena. Una persona con altas capacidades que no puede seguir un diálogo no tiene un problema de inteligencia; tiene un entorno que no está diseñado para ella. Herramientas así devuelven algo tan simple como el derecho a entender lo que se está diciendo sin pelear con el mando a distancia.
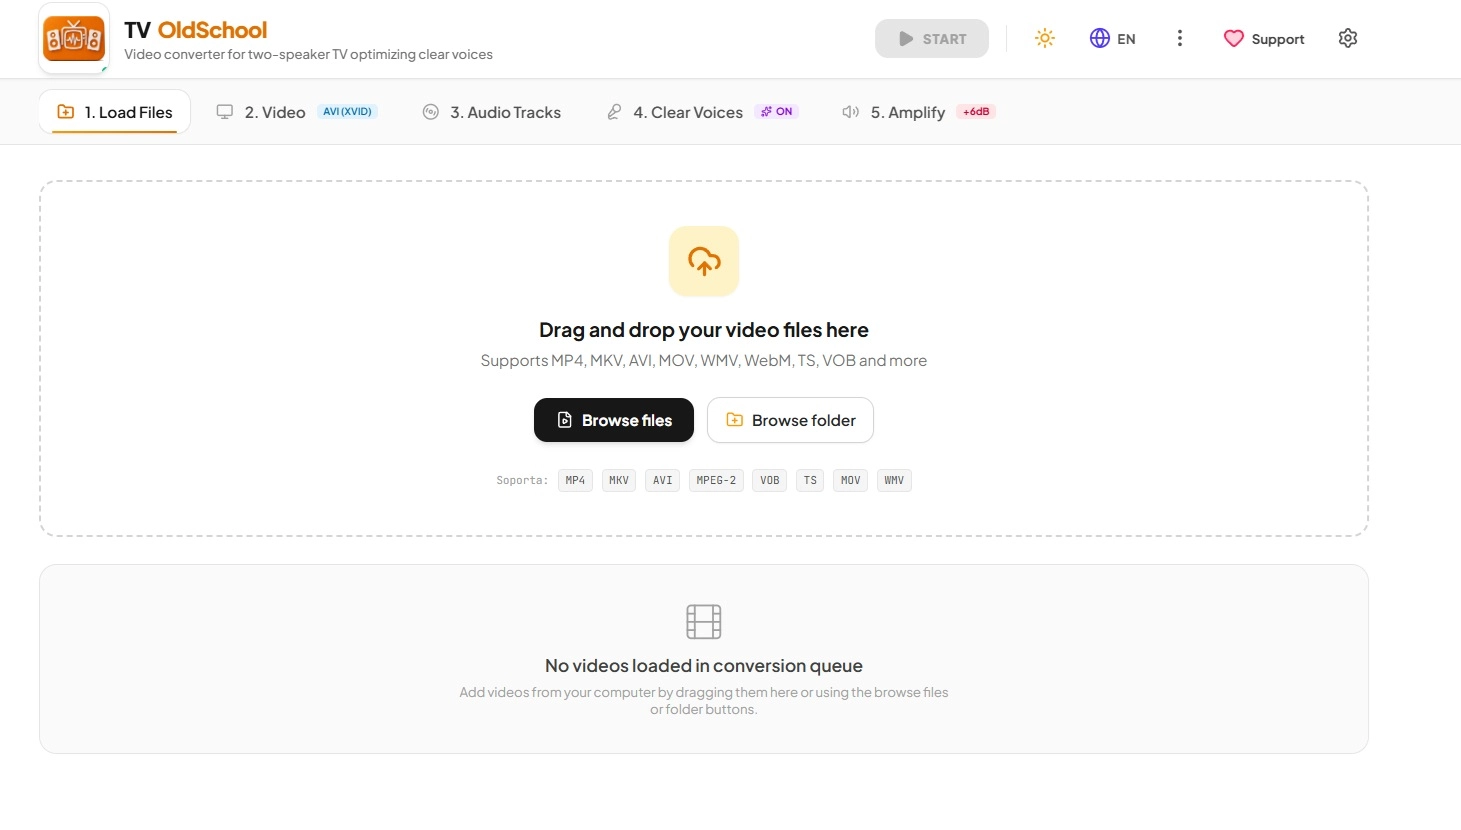
Si quieres probarlo, la implementación se llama TV Old School y procesa el audio de archivos de vídeo en diferido, dejando una pista estéreo. El código está en SourceForge y en GitHub. Y si te interesa la parte formal del trabajo, con sus ecuaciones y su análisis crítico, está publicado en abierto con DOI: https://doi.org/10.5281/zenodo.24437921.
Temas y conceptos clave
Artículos recomendados
Ver todos →Altas capacidades: por qué 9 de cada 10 alumnos pasan sin ser detectados
Se estima que un 10% del alumnado tiene altas capacidades, pero solo se identifica poco más del 1%. Datos, señales de alerta y qué hacer si sospechas.
Desde Libros con Vida, nos han hecho este regalo tan chulo. Entrada, video y podcast
El portal Libros con Vida reseña «Vivir con altas capacidades» en una entrada, un vídeo y un podcast dedicados al libro.
Falacia del coste hundido: por qué seguimos con lo que ya no funciona
Qué es la falacia del coste hundido, por qué cuesta tanto abandonar lo ya invertido y cinco preguntas para decidir sin que el pasado te condicione.